Qué es
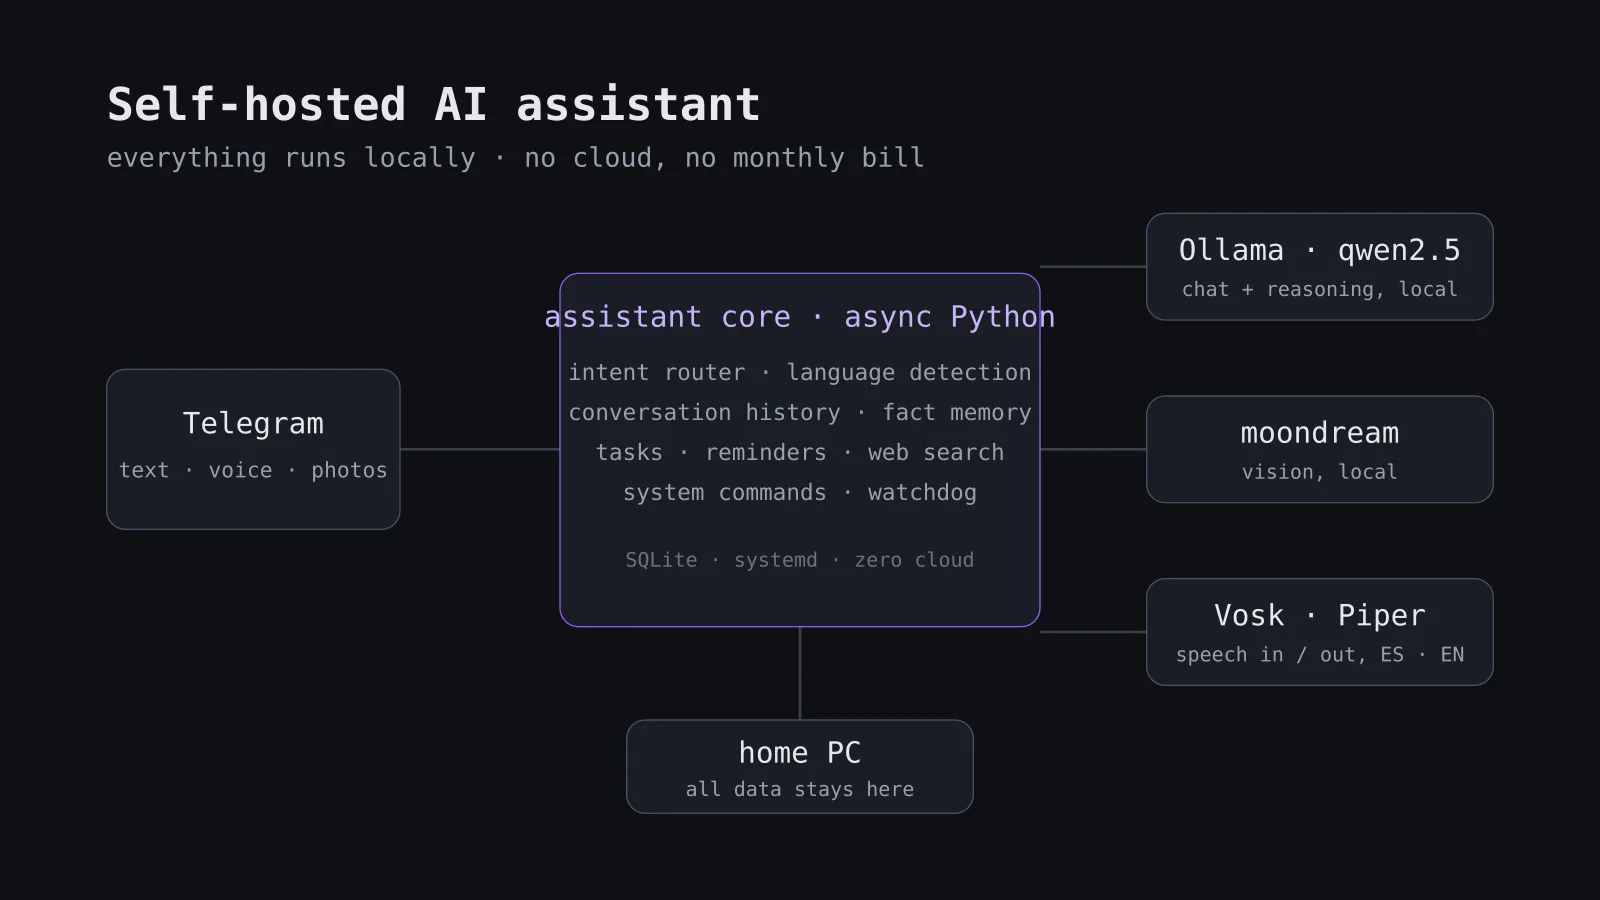
Es el asistente con el que hablo desde el móvil. Vive en un PC de casa, responde por Telegram y todo —el modelo de lenguaje, la visión, el reconocimiento y la síntesis de voz, la memoria— corre en esa máquina. No hay ninguna API en la nube detrás ni cuota mensual. Además hace de mando a distancia del PC: estado de servicios, discos, procesos, descargas, reinicios.
Por qué en local
Tres razones, por orden de importancia:
- Privacidad. Conoce mi agenda, mis notas y mi red de casa. Eso no va en el servidor de otro.
- Coste. Un modelo de 3B parámetros en una GPU de consumo responde en un par de segundos y no cuesta nada por mensaje. Cambia la libertad con la que lo usas.
- Aprendizaje. Ejecutar modelos tú mismo te enseña lo que una API alojada esconde: límites de contexto, VRAM, latencia, cuándo basta un modelo pequeño y cuándo no. El pipeline de detección de duplicados que monté en el trabajo sobre un LLM en local salió directamente de lo aprendido aquí.
Cómo funciona
- Núcleo: Python asíncrono. Cada llamada al modelo se espera con
await, así una respuesta lenta nunca bloquea una nota de voz o un comando de estado. - Chat:
qwen2.5servido por Ollama, residente en memoria (keep_alive) para que el primer token no pague la carga del modelo. El prompt se construye con un perfil de sistema, los últimos turnos de la conversación y una etiqueta de idioma. - Idioma: detección real con lingua (langdetect confundía «Hola» con turco), los mensajes cortos heredan el idioma del turno anterior y un comando
/deshacercorrige una detección errónea. - Visión: las fotos van a
moondream, un modelo de visión pequeño y local, para descripciones y preguntas sencillas sobre una imagen. - Voz: Vosk transcribe español e inglés sin conexión; Piper sintetiza la respuesta. Las notas de voz se enrutan por intención: «tarea comprar pan» crea una tarea, «buscar …» consulta la web, el resto es chat.
- Memoria: un extractor en segundo plano lee cada conversación y propone hechos sobre el usuario; los confirmados se guardan en SQLite y se inyectan en prompts posteriores. El historial migró de un JSON a SQLite con un script de verificación que comparó todos los recuentos.
- Herramientas: búsqueda en DuckDuckGo, tareas y recordatorios, búsqueda de archivos, consulta de vuelos, gestión de servicios y un
/statusque informa de VRAM, modelos cargados y temperatura de la GPU. - Operación: dos servicios systemd con watchdog, logging estructurado, timeouts en todas las llamadas al modelo y copias nocturnas de la base de datos.
Qué aprendí
- Los modelos pequeños necesitan prompts cortos. Un 3B sigue mucho mejor un prompt de sistema breve y explícito que uno largo; la estructura gana a la verborrea.
- Primero reglas, luego modelo. Enrutar intenciones por palabras clave es más rápido y predecible que preguntarle al modelo qué quiso decir el usuario. El LLM se queda con lo que las reglas no resuelven.
- Verificar las migraciones como en el trabajo. Mover la memoria de JSON a SQLite recibió el mismo trato que una migración de datos en la empresa: recuentos comparados a ambos lados antes de cambiar.
- La contaminación existe. Unas pocas respuestas en inglés a mensajes en español acabaron en el historial y sesgaron respuestas posteriores. Ahora el historial se purga de pares con idiomas mezclados y la etiqueta de idioma es explícita.
Estado
En uso diario. Siguiente paso: sustituir el enrutado por palabras clave por un clasificador pequeño y un conjunto de evaluación de respuestas para medir las mejoras de modelo en vez de intuirlas.